Wie wir Übersetzungsqualität wirklich messen und warum die meisten Benchmarks falschliegen
Wir haben unser eigenes Evaluierungs-Framework entwickelt. Und die Methodik dahinter ist nuancierter, als die meisten erwarten.
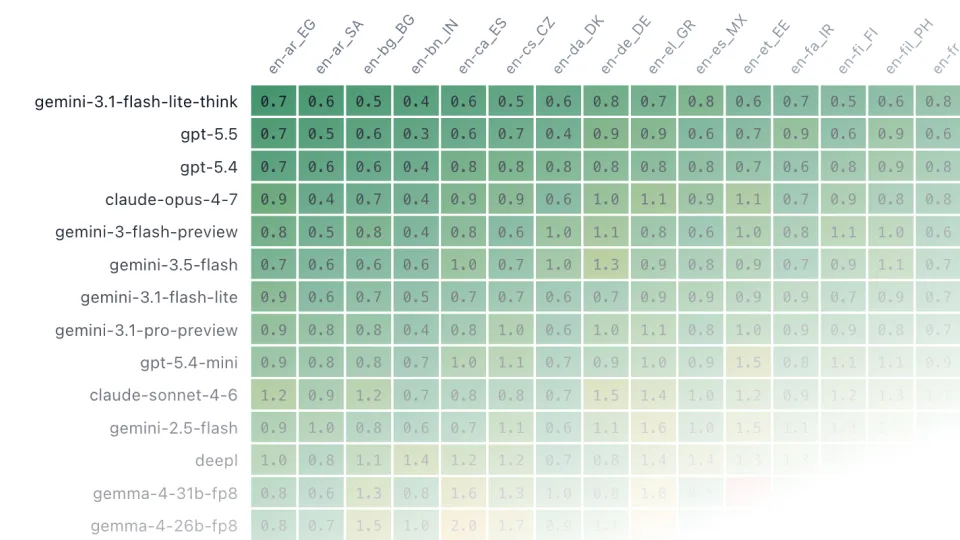
Bei SyncWords überwinden wir Sprachbarrieren für Live-Audio in Echtzeit. In jeder Sekunde einer Übertragung entscheiden wir, welches Übersetzungssystem für welches Sprachpaar zu welchen Kosten und mit welcher Ausfalltoleranz eingesetzt wird.
Das bedeutet, dass wir uns nicht auf Marketingpräsentationen oder Benchmarks von Anbietern verlassen können. Wir müssen mit statistischer Sicherheit wissen, welche Engine für ein bestimmtes Sprachpaar heute am besten abschneidet.
Deshalb haben wir unser eigenes Evaluierungs-Framework entwickelt. Und die Methodik dahinter ist nuancierter, als die meisten erwarten.
Dieser Beitrag liefert das vollständige technische Gesamtbild.
_________________________
Erhalten Sie kostenlosen Zugang zu dem Tool, das wir für den Vergleich maschineller Übersetzungs-Engines nutzen
Warum Standard-Benchmarks nicht ausreichen
Der Standardansatz zur Evaluierung von MT besteht darin, einen Benchmark-Datensatz auszuwählen, die Systeme darauf laufen zu lassen und einen einzelnen Wert auszugeben. Ganz einfach.
Das Problem dabei ist, dass dieser einzelne Wert fast alles verbirgt, worauf es in der Produktion ankommt.
Er sagt Ihnen nicht, ob das System stillschweigend fehlgeschlagen ist. Er sagt Ihnen nicht, ob die „präzise“ Ausgabe zwar in der Standardsprache korrekt, für Ihr regionales Publikum jedoch falsch ist. Er sagt Ihnen nicht, was der Betrieb des Systems bei einer Echtzeit-Sprechgeschwindigkeit kostet. Und er sagt Ihnen schon gar nicht, ob sich die Zahl, die Sie vor sich sehen, statistisch von dem unmittelbar darunter platzierten System unterscheidet.
Wir haben unser Framework auf der Grundlage des WMT24++-Datensatzes entwickelt, um genau das offenzulegen. So funktioniert es.
Der Datensatz: WMT24++
WMT24++ ist ein post-editiertes paralleles Korpus, das 55 Sprachpaare (Englisch → Zielsprache) mit 960 Segmenten pro Paar abdeckt. Die Referenzen sind menschliche Post-Edits, nicht maschinell generiert und keine Rohübersetzungen, was sie zu einem zuverlässigen Anker für die Qualität macht.
Jedes von uns evaluierte System übersetzt alle 960 Segmente für jedes von ihm unterstützte Sprachpaar. Das liefert uns 960 Datenpunkte pro Zelle (System, Sprachpaar), genug um enge Konfidenzintervalle zu berechnen und Fehlermuster auf Segment-Ebene zu erkennen.
Zwei Metriken statt einer
Kern unserer Evaluierung sind zwei unabhängige Qualitätssignale, die zusammen eingesetzt werden. Keines davon reicht allein aus.
MetricX24 (Referenzbasiert)
MetricX-24-Hybrid-XL ist die gelernte MT-Qualitätsmetrik von Google Research, ein mT5-Modell mit ungefähr 3.7 Milliarden Parametern, das darauf trainiert wurde, einen Qualitätswert aus (Quelle, Hypothese, Referenz)-Trippeln zu berechnen. Es ist eine der leistungsfähigsten verfügbaren referenzbasierten Metriken und korreliert in kontrollierten Umgebungen gut mit menschlichen Bewertungen.
Es weist jedoch eine bekannte Verzerrung auf, die wir explizit berücksichtigen: Es belohnt „neutrale Standard“-Ausgaben gegenüber regional authentischen Übersetzungen.
In der Praxis bedeutet dies, dass MetricX ein System systematisch abstraft, das korrekterweise ägyptisch-arabischen Dialekt statt Hocharabisch, Quebec-Französisch statt Pariser Französisch oder mexikanisches Spanisch statt Kastilisch erzeugt. Die Metrik wurde überwiegend auf „Standard“-Sprachreferenzen trainiert und spiegelt dies wider.
Für ein Unternehmen, das in Märkten wie LATAM, US Hispanic und dem Nahen Osten tätig ist, wo dialektale Genauigkeit den Unterschied zwischen Inhalten ausmacht, die ankommen, und solchen, die fremd wirken, ist diese Verzerrung keine Nebensache. Es ist ein fundamentales Problem, wenn man sich auf eine einzelne Metrik verlässt.
MetricX ist dennoch wertvoll. Es ist ein präzises, reproduzierbares Signal. Aber es benötigt eine korrigierende zweite Meinung.
GEMBA-MQM (LLM-as-Judge)
GEMBA-MQM liefert diese zweite Meinung. Anstatt mit einer Referenzübersetzung zu vergleichen, fordert es ein führendes Sprachmodell auf, Fehler direkt mithilfe der MQM-Taxonomie (Multidimensional Quality Metrics) zu annotieren.
Dem Evaluator wird (Quelle, Referenz, Kandidat) vorgelegt und er wird gebeten, Fehler über sechs Dimensionen hinweg zu identifizieren: Genauigkeit/Falschübersetzung, Flüssigkeit/Grammatik, Stil, Gebietsschema/Format und Terminologie, jeweils in einer von drei Schweregradstufen.
Der Segmentwert ist die nach WMT-standard-Schweregrad gewichtete Summe, gedeckelt auf 25:
score = min(25, Σ severity_weight(e))
Wobei minor = 1, major = 5, critical = 25.
Zwei Designentscheidungen machen dies in der Praxis zuverlässig.
Erstens ist die Argumentation (Reasoning) für alle Evaluatoren aktiviert. Ohne Chain-of-Thought-Reasoning halluzinieren LLM-Evaluatoren Fehler: Sie liefern selbstbewusste Bewertungen ohne Grundlage in der tatsächlichen Übersetzung. Mit aktivierter Argumentation (thinking_budget=-1 dynamisch für Gemini, reasoning_effort=medium für GPT) erzeugen die Evaluatoren Annotationen, die kohärent und überprüfbar sind.
Zweitens weist der Prompt die Evaluatoren explizit an, regionale und dialektale Varianten als gültige Übersetzungen zu behandeln. Dies begegnet direkt der Standardsprachen-Verzerrung von MetricX. Ein System, das einen korrekten ägyptisch-arabischen Dialekt liefert, sollte dafür nicht bestraft werden, und mit dem Prompt-Design von GEMBA wird es das auch nicht.
Wir führen derzeit mehrere Evaluatoren gleichzeitig aus. Jeder schreibt in sein eigenes Ergebnisverzeichnis; der Bericht erkennt automatisch alle Evaluatoren und stellt eine Spalte pro Evaluator dar. Eine hohe Übereinstimmung zwischen den Evaluatoren ist ein Signal für eine hohe Verlässlichkeit. Uneinigkeit zwischen den Evaluatoren markiert die Stellen, an denen die Metrik selbst unsicher ist, was für sich genommen ebenfalls eine nützliche Information ist.
Was ist die GEMBA Rate? Die GEMBA Rate (im Tool dargestellt als GEMBA Combined im Tool) ist der durchschnittliche Wert über alle aktiven Evaluatoren für eine bestimmte Zelle (System, Sprachpaar). Es ist die zentrale GEMBA-Zahl, die einzelne Kennzahl, auf die Sie schauen sollten, wenn Sie einen schnellen Überblick über die Übersetzungsqualität wünschen. Die Spalten der einzelnen Evaluatoren (z. B. GEMBA Gemini-3.1-Flash-Lite, GEMBA GPT-5.4-Mini) stehen daneben, damit Sie sehen können, wo die Evaluatoren übereinstimmen und wo sie abweichen. Wenn die kombinierte Rate niedrig ist und die einzelnen Evaluatoren nah beieinander liegen, haben Sie ein hochgradig verlässliches Qualitätssignal. Wenn die Evaluatoren deutlich voneinander abweichen, betrachten Sie die kombinierte Rate nur als Richtwert und prüfen Sie die einzelnen Evaluatorenspalten.
Beide Werte zusammen interpretieren
MetricX und GEMBA lassen sich am besten wie folgt nebeneinander interpretieren: MetricX sagt Ihnen, wie nah die Ausgabe an einer Standardreferenz liegt. GEMBA sagt Ihnen, ob ein qualifizierter Leser tatsächlich Fehler darin finden würde.
Wenn sie übereinstimmen (stark bei beiden), haben Sie ein verlässliches Signal. Wenn MetricX ein System schlechter bewertet als GEMBA, handelt es sich wahrscheinlich um eine regional authentische Ausgabe, die von MetricX abgestraft wird. Wenn GEMBA schlechter abschneidet als MetricX, liegt die Ausgabe zwar technisch möglicherweise nah an der Referenz, enthält jedoch echte Probleme bei Flüssigkeit oder Genauigkeit, die einem Menschen auffallen würden.
Beide Werte liegen auf derselben Skala von 0 bis 25. Bei beiden ist ein niedrigerer Wert besser.
Konfidenzintervalle
Jede Zelle im Bericht zeigt Mittelwert ± Halbwertsbreite eines 95%-Bootstrap-Konfidenzintervalls auf den Segmentmittelwert.
Das ist wichtiger, als die meisten Evaluierungsberichte einräumen. Bei 960 Segmenten sind die systemweiten CIs typischerweise eng, etwa ±0.02. Die CIs pro Sprachpaar sind breiter, etwa ±0.10, aber immer noch aussagekräftig.
Die praktische Konsequenz: Wenn sich die Konfidenzintervalle zweier Systeme überschneiden, liegen sie statistisch gleichauf. Ein System über das andere zu stellen, ist dann nicht vertretbar. Der Bericht spiegelt dies wider: Wir erklären keinen Gewinner, wo die Daten keinen hergeben.
Kosten: Was der Betrieb bei Sprechgeschwindigkeit tatsächlich kostet
Die Angabe $/Std. in unserem Bericht ist keine Preisliste von API. Es ist eine Schätzung der Kosten für den Betrieb jedes Systems als einzelner Echtzeit-Übersetzungs-Stream für einen menschlichen Sprecher.
Wir nutzen ca. 750 Zeichen pro Minute als Grundwert, was dem durchschnittlichen englischen Sprechtempo entspricht. Der schnellste Produktions-Stream, den wir beobachtet haben, läuft mit ca. 1,200 Zeichen/Min.; die Kosten skalieren linear.
Bei LLM-Systemen werden die Kosten pro Token auf der Grundlage des Produktions-Prompts plus eines kumulierten Kontextfensters von 7 Teilen berechnet, ohne Rabatt für Prompt-Caching anzunehmen (konservative Schätzung). Bei NMT-Systemen (DeepL, Google Translate, Amazon Translate) werden die Kosten pro Zeichen anhand vertraglicher oder öffentlicher Tarife berechnet.
Ein wichtiger Hinweis: Systeme im Absatzmodus (Paragraph Mode) zeigen die Kostenschätzung des Satzmodus (Sentence Mode) an, da der Produktionsbetrieb nie im Absatzmodus läuft. Eine Kostenschätzung im Absatzmodus wäre künstlich niedrig und für reale Einsatzentscheidungen irreführend.
Fehlerklassifizierung
Das ist der Teil, den die meisten Benchmarks völlig ignorieren.
Eine schlechte Übersetzung erhält einen hohen Punktwert. Ein katastrophaler Ausfall (ein System, das die Übersetzung verweigert hat, in einer Endlosschleife lief oder stillschweigend nichts zurückgegeben hat) wird als Null erfasst, was Durchschnitte verzerrt und das tatsächliche Risiko verbirgt.
Wir kennzeichnen jedes Segment mit einem oder mehreren Fehler-Flags. Ein Segment gilt als „fehlgeschlagen“, wenn ein beliebiges Flag ausgelöst wird. Schlechte, aber nicht abgebrochene Übersetzungen werden nicht geflaggt; sie erscheinen als hohe Punktwerte in MetricX und GEMBA.
Ausfälle auf API-Ebene sind betrieblich am bedeutsamsten:
stuck, degenerierte Dekodierungsschleife. Das Modell gibt wiederholt denselben Token aus, was normalerweise durch Quelltext mit sich wiederholenden Zeichen ausgelöst wird (noooooOOOOoo,waaaaahoooo!!). Die Erhöhung des Token-Budgets führt zu weiteren Schleifen-Tokens, nicht zu einer besseren Übersetzung, weshalb wir begrenzen und flaggen.refused, das Modell hat die Übersetzung verweigert. Deckt den Anti-Memorization-Filter von Gemini (RECITATION), Sicherheitsfilter und Inhalts-Blocklisten ab. Das Segment ist für dieses System dauerhaft unzugänglich.api_error, Infrastrukturausfälle: Nicht-429-4xx-Fehler, gRPC-Timeouts nach Erschöpfung der Wiederholungsversuche. Die Kategorie, auf die Sie achten sollten, wenn Sie sich fragen: „Ist die Integration defekt?“empty, API-Aufruf war erfolgreich, das Modell hat einen leeren String zurückgegeben. Unterscheidet sich von den oben genannten Fehlern.
Fehler in der Ausgabestruktur erfassen Modelle, die technisch gesehen etwas zurückgegeben haben, aber keine Übersetzung:
untranslated, Hypothese entspricht der Quelle. Wir überspringen kurze Segmente, überwiegend nicht-alphabetischen Text und Inhalte, die legitimerweise nicht übersetzbar sind (Hashtags, URLs, @mentions).markdown_fence, das Modell hat die Ausgabe trotz ausdrücklicher Anweisung, dies nicht zu tun, in Code-Blöcke eingeschlossen.preamble, Ausgabe beginnt mit„Translation:“,„Here's the translation“oder Entsprechungen des jeweiligen Gebietsschemas. Das Modell hat sich nicht an das Ausgabeformat gehalten.reasoning_leak, das Modell hat seinen internen Chain-of-Thought in der Ausgabe offengelegt. Weist auf ein falsch konfiguriertes hybrides Reasoning-Modell hin.multiple_alternatives, das Modell hat Optionen anstelle einer einzelnen Übersetzung angeboten.translator_note, ein vom Modell hinzugefügter nachstehender Klammerzusatz.
Die Spalte für die Fehlerrate im Bericht fasst all diese zusammen. Ein System mit einer Fehlerrate von 0% bei Ihrem Zielsprachpaar unterscheidet sich erheblich von einem mit 2 bis 3%, insbesondere bei Live-Übertragungen, wo ein fehlgeschlagenes Segment Stille oder unbrauchbaren Ton auf Sendung bedeutet.
Was das für Produktionsentscheidungen bedeutet
Der Grund, warum wir dieses Evaluierungs-Framework entwickelt haben, und der Grund, warum wir es öffentlich zugänglich machen, liegt darin, dass die Auswahl der Übersetzungs-Engine keine einmalige Entscheidung ist.
Modellfähigkeiten ändern sich. Neue Versionen werden veröffentlicht. Preisstrukturen verändern sich. Die Abdeckung von Sprachpaaren wird erweitert. Ein System, das vor sechs Monaten die richtige Wahl für Englisch → Spanisch war, ist es heute möglicherweise nicht mehr.
Wir führen diese Evaluierung kontinuierlich durch. Das Tool spiegelt die aktuelle Leistung wider, keine archivierten Benchmarks.
Für Broadcaster und Streaming-Dienste, die in mehrsprachigen Märkten tätig sind, geht es um viel: Die falsche Engine für ein Sprachpaar bedeutet eine geringere Ausgabequalität, höhere Kosten oder ein höheres Ausfallrisiko bei Live-Inhalten. Richtige Entscheidungen erfordern Daten, keine Annahmen.
Genau dafür wurde dieses Framework entwickelt.
Das Engine-Vergleichstool von MT ist kostenlos. Fordern Sie Zugang unter syncwords.com an oder kontaktieren Sie uns direkt: Wir gehen gerne mit Ihnen durch, was die Daten für Ihre spezifischen Sprachpaare zeigen.
Vergleichen Sie Übersetzungs-Engines selbst mit unserem kostenlosen Tool
Kostenlosen Zugang erhalten