Comment nous mesurons réellement la qualité de la traduction, et pourquoi la plupart des benchmarks se trompent
Nous avons conçu notre propre cadre d’évaluation. Sa méthodologie est plus nuancée que ne le laissent penser la plupart des benchmarks.
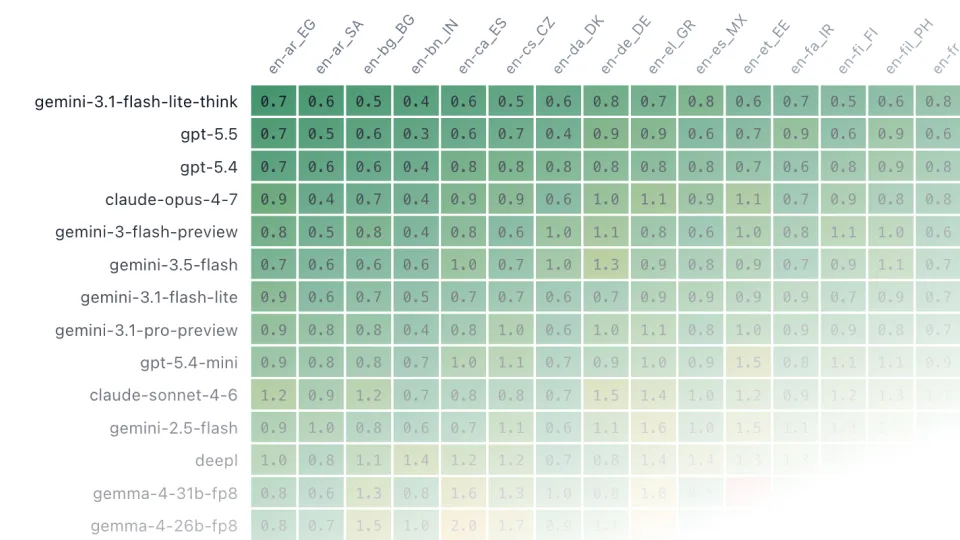
Chez SyncWords, nous faisons passer l’audio en direct d’une langue à une autre en temps réel. À chaque seconde de diffusion, nous choisissons le système de traduction à exécuter, pour quelle combinaison linguistique, à quel coût et avec quelle tolérance aux défaillances.
Nous ne pouvons donc pas nous fier aux présentations commerciales ni aux benchmarks fournis par les prestataires. Nous devons déterminer, avec une confiance statistique, quel moteur obtient les meilleurs résultats pour une combinaison linguistique donnée au moment de l’évaluation.
Nous avons créé un cadre d’évaluation indépendant dont la méthodologie intègre davantage de nuances que les benchmarks habituels.
Cet article présente l’ensemble de l’approche technique.
_________________________
Demandez un accès gratuit à l’outil que nous utilisons pour comparer les moteurs de traduction automatique
Pourquoi les benchmarks génériques ne suffisent pas
L’approche habituelle pour évaluer la traduction automatique consiste à choisir un jeu de données de référence, à exécuter plusieurs systèmes et à communiquer un score unique.
Le problème est que ce chiffre unique masque une grande partie de ce qui compte en production.
Il n’indique pas si le système a échoué silencieusement, si une sortie jugée « précise » en langue standard convient réellement au public régional, ni combien coûte le fonctionnement du système au rythme de la parole en temps réel. Il ne permet pas non plus de savoir si le résultat observé diffère statistiquement de celui du système classé juste derrière.
Notre cadre, construit à partir du jeu de données WMT24++, met ces aspects en évidence. Voici comment il fonctionne.
Le jeu de données : WMT24++
WMT24++ est un corpus parallèle post-édité qui couvre 55 combinaisons linguistiques, de l’anglais vers la langue cible, avec 960 segments par combinaison. Les références sont des post-éditions humaines, et non des traductions automatiques brutes, ce qui fournit une base cohérente pour évaluer la qualité.
Chaque système évalué traduit les 960 segments de chaque combinaison linguistique compatible. Nous obtenons ainsi 960 points de données par cellule de système et combinaison, suffisamment pour calculer des intervalles de confiance étroits et détecter les schémas de défaillance par segment.
Deux métriques, pas une seule
L’évaluation associe deux indicateurs de qualité indépendants. Aucun ne suffit à lui seul.
MetricX-24, fondée sur des références
MetricX-24-Hybrid-XL est un indicateur appris de la qualité de traduction automatique développé par Google Research. Il utilise un modèle mT5 de 3,7 milliards de paramètres, entraîné pour produire un score de qualité à partir des triplets (source, hypothesis, reference). Il s’agit d’un indicateur de référence performant qui présente une corrélation avec les jugements humains dans des conditions contrôlées.
Cette métrique présente toutefois un biais connu dont nous tenons explicitement compte : elle favorise les sorties en langue standard neutre au détriment des traductions régionales authentiques.
En pratique, MetricX pénalise systématiquement un système qui produit correctement de l’arabe égyptien plutôt que de l’arabe standard moderne, du français québécois plutôt que du français parisien, ou de l’espagnol mexicain plutôt que du castillan. La métrique a été entraînée principalement sur des références en langue standard, et ses résultats reflètent ce choix.
Pour une entreprise présente sur des marchés tels que l’Amérique latine, la communauté hispanique des États-Unis et le Moyen-Orient, l’authenticité dialectale peut déterminer si le contenu paraît naturel ou étranger. Ce biais constitue donc un obstacle majeur à l’utilisation d’un indicateur unique.
MetricX reste un signal précis et reproductible, mais nécessite une seconde évaluation complémentaire.
GEMBA-MQM, évaluation via LLM
GEMBA-MQM apporte cette seconde évaluation. Au lieu de comparer la sortie à une traduction de référence, cette méthode demande à un modèle de langage de pointe d’annoter directement les erreurs selon la taxonomie MQM (Multidimensional Quality Metrics).
L’évaluateur reçoit (source, reference, candidate) et doit identifier les erreurs selon six dimensions : exactitude ou erreur de traduction, fluidité ou grammaire, style, paramètres régionaux ou format, et terminologie, chacune avec l’un des trois niveaux de gravité.
Le score du segment est la somme pondérée par gravité selon la norme WMT, plafonnée à 25 :
Formule utilisée : score = min(25, Σ severity_weight(e))
Où minor = 1, major = 5, critical = 25.
Deux décisions de conception améliorent la fiabilité pratique.
Premièrement, le raisonnement est activé pour tous les évaluateurs. Sans cette configuration, les LLM peuvent attribuer des erreurs inexistantes et produire des scores assurés sans fondement clair dans la traduction. Lorsque le raisonnement est activé (thinking_budget=-1 avec un budget dynamique pour Gemini et reasoning_effort=medium pour GPT), les annotations deviennent cohérentes et auditables.
Deuxièmement, l’instruction précise explicitement que les variantes régionales et dialectales sont des traductions valides. Elle compense ainsi le biais de MetricX en faveur de la langue standard. Une sortie correcte en arabe égyptien ne doit pas être pénalisée pour l’emploi de cette variété, ce que prend en compte la conception de l’instruction GEMBA.
Nous exécutons actuellement plusieurs évaluateurs en parallèle. Chacun écrit dans son propre répertoire de résultats ; le rapport les détecte automatiquement et affiche une colonne pour chacun. Une forte concordance produit un signal plus fiable. Les divergences indiquent les points où l’indicateur lui-même reste incertain, ce qui constitue aussi une information utile.
Qu’est-ce que le taux GEMBA ? Le taux GEMBA, affiché comme GEMBA Combined dans l’outil, correspond au score moyen de tous les évaluateurs actifs pour une cellule donnée de système et de combinaison linguistique. Il s’agit du chiffre de synthèse GEMBA. Les colonnes de chaque évaluateur, par exemple GEMBA Gemini-3.1-Flash-Lite et GEMBA GPT-5.4-Mini, figurent à côté pour montrer leurs convergences et leurs divergences. Si le taux combiné est faible et que les scores individuels sont proches, le signal de qualité est plus fiable. S’ils divergent nettement, le taux combiné doit être interprété comme une indication et les colonnes individuelles doivent être examinées.
Comment interpréter les deux métriques
MetricX indique dans quelle mesure la sortie se rapproche d’une référence standard. GEMBA indique si un lecteur qualifié y trouverait des erreurs.
Lorsque les deux métriques produisent un résultat solide, le signal est cohérent. Si MetricX note un système moins bien que GEMBA, il peut s’agir d’une sortie régionale authentique pénalisée par MetricX. Si GEMBA le note moins bien que MetricX, la sortie peut être proche de la référence tout en présentant de réels problèmes de fluidité ou d’exactitude.
Les deux scores utilisent la même échelle de 0 à 25. Plus le score est faible, meilleur il est.
Intervalles de confiance
Chaque cellule du rapport montre mean ± half-width d’un intervalle de confiance bootstrap à 95 % sur la moyenne des segments.
Cette donnée compte davantage que ne le reconnaissent la plupart des rapports d’évaluation. Avec 960 segments, les intervalles de confiance à l’échelle du système sont généralement étroits, autour de ±0,02. Ils sont plus larges par combinaison linguistique, autour de ±0,10, mais restent significatifs.
En pratique, deux systèmes dont les intervalles se chevauchent sont statistiquement ex aequo. Il n’est pas défendable de classer l’un au-dessus de l’autre. Le rapport respecte cette limite et ne désigne pas de gagnant lorsque les données ne l’étayent pas.
Coût : combien revient l’exécution du système au rythme de la parole
Le chiffre $/hr du rapport n’est pas un tableau des tarifs des API. Il estime le coût d’exécution de chaque système pour un seul flux de traduction en temps réel pendant une heure.
Nous utilisons 750 caractères par minute comme référence, à partir d’un débit moyen en anglais. Le flux de production le plus rapide observé atteint 1 200 caractères par minute ; les coûts évoluent linéairement.
Pour les systèmes LLM, le coût est calculé par jeton à partir de l’instruction de production et d’une fenêtre de contexte cumulée de sept fragments, sans remise liée à la mise en cache des instructions, ce qui fournit une estimation prudente. Pour les systèmes NMT, comme DeepL, Google Translate et Amazon Translate, il est calculé par caractère selon les tarifs publics ou contractuels.
Une précision importante : les systèmes de traduction par paragraphes affichent ici l’estimation du mode par phrases, car la production n’utilise jamais le mode par paragraphes. Estimer ce dernier réduirait artificiellement le coût et conduirait à de mauvaises décisions de déploiement.
Classification des défaillances
C’est un aspect que de nombreux benchmarks omettent.
Une traduction médiocre obtient un score élevé. Une défaillance catastrophique, par exemple un système qui refuse de traduire, entre dans une boucle ou renvoie une chaîne vide, pourrait être enregistrée comme un zéro, fausser la moyenne et masquer le risque réel.
Nous associons à chaque segment un ou plusieurs indicateurs de défaillance. Un segment est considéré comme défaillant dès qu’un indicateur se déclenche. Les traductions médiocres mais techniquement valides ne sont pas signalées comme des défaillances : elles apparaissent sous la forme de scores élevés dans MetricX et GEMBA.
Défaillances de l’API sont les plus pertinentes du point de vue opérationnel :
stuck: boucle de décodage dégénérée. Le modèle répète le même jeton, généralement après avoir reçu un texte source contenant des caractères répétés (nooooooooooo,waaaaahoooo!!). Augmenter le budget de jetons ne produit que davantage de jetons répétés, et non une meilleure traduction. Nous limitons donc la sortie et la signalons.refused: le modèle a refusé de traduire. Cela comprend le filtre de mémorisation de Gemini (RECITATION) ainsi que les filtres de sécurité et les autres blocages de contenu. Le segment reste inaccessible pour ce système.api_protectionDéfaillances d’infrastructure : erreurs 4xx autres que 429 et expirations gRPC après épuisement des nouvelles tentatives. C’est la catégorie à surveiller pour déterminer si l’intégration est défaillante.empty: la requête à l’API a abouti, mais le modèle a renvoyé une chaîne vide. Ce cas se distingue des défaillances précédentes.
Défaillances de structure de sortie concernent les modèles qui ont techniquement renvoyé du contenu, mais pas une traduction :
untranslated: l’hypothèse correspond à la source. Nous omettons les segments courts, le texte principalement non alphabétique et les contenus à ne pas traduire, tels que les hashtags, les URL ou les mentions.markdown_fence: le modèle a encadré la sortie dans des blocs de code malgré l’instruction explicite de ne pas le faire.preamble: la sortie commence par« Traduction : »,« Voici la traduction »ou une formulation équivalente. Le modèle n’a pas respecté le format de sortie.reasoning_leak: le modèle a exposé son raisonnement interne dans la sortie, ce qui indique une mauvaise configuration d’un modèle de raisonnement hybride.multiple_alternatives: le modèle a proposé plusieurs options au lieu d’une seule traduction.translator_note: le modèle a ajouté une note finale entre parenthèses.
La colonne du taux de défaillance regroupe tous ces indicateurs. Un système affichant un taux de 0 % pour une combinaison linguistique donnée diffère sensiblement d’un système à 2 ou 3 %, surtout en direct, où l’échec d’un segment entraîne un silence ou un contenu incorrect à l’antenne.
Ce que cela change pour les décisions de production
Nous avons créé ce cadre et le rendons public, car le choix d’un moteur de traduction n’est pas une décision ponctuelle.
Les capacités des modèles évoluent, de nouvelles versions apparaissent, les tarifs changent et la couverture linguistique augmente. Le système adapté à l’anglais vers l’espagnol il y a six mois ne l’est peut-être plus aujourd’hui.
Nous exécutons l’évaluation en continu. L’outil reflète les performances actuelles, et non des benchmarks archivés.
Pour les chaînes et les services de streaming qui se développent sur des marchés multilingues, choisir un moteur inadapté à une combinaison linguistique peut réduire la qualité, augmenter les coûts ou accroître le risque de défaillance en direct. Cette décision exige des données, pas des hypothèses.
Ce cadre est conçu pour fournir ces données.
L’outil de comparaison des moteurs de traduction automatique est désormais disponible. Demandez un accès sur SyncWords.com ou contactez-nous directement pour examiner les données correspondant à vos combinaisons linguistiques.
Compare mars de traduction avec notre outil supprimer
Demander un accès gratuit