Cómo medimos realmente la calidad de la traducción y por qué muchos benchmarks se equivocan
Creamos un marco propio para evaluar motores de traducción por combinación lingüística, con métricas complementarias, intervalos de confianza, costes y fallos.
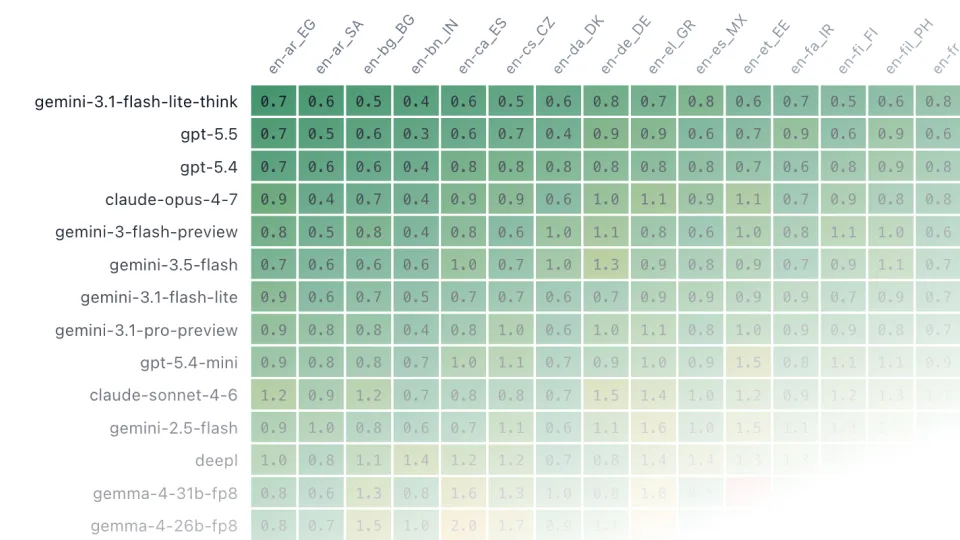
En SyncWords trasladamos audio en directo de un idioma a otro en tiempo real. En cada segundo de emisión decidimos qué sistema de traducción ejecutar, para qué combinación lingüística, con qué coste y con qué tolerancia a los fallos.
Por eso no podemos depender de presentaciones comerciales ni de benchmarks proporcionados por los proveedores. Necesitamos saber, con confianza estadística, qué motor obtiene mejores resultados para una combinación lingüística concreta en el momento de la evaluación.
Creamos un marco de evaluación propio cuya metodología incorpora más matices de los que suelen mostrar los benchmarks.
Este artículo presenta el enfoque técnico completo.
_________________________
Solicite acceso gratuito a la herramienta que utilizamos para comparar motores de traducción automática
Por qué no bastan los benchmarks genéricos
El enfoque habitual para evaluar traducción automática consiste en elegir un conjunto de referencia, ejecutar varios sistemas y comunicar una única puntuación.
El problema es que esa cifra oculta gran parte de lo que importa en producción.
No indica si el sistema ha fallado sin avisar, si una salida correcta en el idioma estándar resulta inadecuada para una audiencia regional, cuánto cuesta ejecutarlo al ritmo del habla en tiempo real ni si la diferencia con el sistema situado inmediatamente después es estadísticamente significativa.
Nuestro marco, construido sobre el conjunto WMT24++, muestra esos aspectos. Así funciona.
El conjunto de datos: WMT24++
WMT24++ es un corpus paralelo poseditado que abarca 55 combinaciones lingüísticas, del inglés al idioma de destino, con 960 segmentos por combinación. Las referencias son posediciones humanas, no traducciones automáticas ni traducciones sin revisar, por lo que ofrecen una base consistente para evaluar calidad.
Cada sistema traduce los 960 segmentos de cada combinación lingüística compatible. Así obtenemos 960 puntos de datos por celda de sistema y combinación, suficientes para calcular intervalos de confianza estrechos y detectar patrones de fallo por segmento.
Dos métricas, no una
La evaluación combina dos señales de calidad independientes. Ninguna basta por sí sola.
MetricX24, basada en referencias
MetricX-24-Hybrid-XL es una métrica de calidad de traducción automática aprendida por Google Research. Utiliza un modelo mT5 de aproximadamente 3.7 mil millones de parámetros, entrenado para obtener una puntuación de calidad a partir de ternas (source, hypothesis, reference). Es una métrica de referencia con buen rendimiento y muestra correlación con juicios humanos en condiciones controladas.
Sin embargo, tiene un sesgo conocido que nuestro marco trata expresamente: favorece las salidas en una variedad estándar neutra frente a traducciones regionales auténticas.
En la práctica, MetricX puede penalizar una traducción correcta al dialecto árabe egipcio frente al árabe moderno estándar, al francés de Quebec frente al de París o al español de México frente al de España. La métrica se entrenó principalmente con referencias en variedades estándar y refleja esa composición.
Para una empresa que trabaja en mercados como Latinoamérica, la comunidad hispana de Estados Unidos y Oriente Medio, la autenticidad dialectal puede determinar si el contenido resulta natural o ajeno. Por eso este sesgo impide depender de una única métrica.
MetricX sigue siendo una señal precisa y reproducible, pero necesita una segunda evaluación complementaria.
GEMBA-MQM, evaluación mediante LLM
GEMBA-MQM aporta esa segunda evaluación. En vez de comparar la salida con una traducción de referencia, pide a un modelo lingüístico avanzado que anote directamente los errores según la taxonomía MQM (Multidimensional Quality Metrics).
El evaluador recibe (source, reference, candidate) y debe identificar errores en seis dimensiones: exactitud o traducción incorrecta, fluidez o gramática, estilo, configuración regional o formato y terminología, cada uno con uno de tres niveles de gravedad.
La puntuación del segmento es la suma ponderada por gravedad del estándar WMT, con un máximo de 25:
score = min(25, Σ severity_weight(e))
Donde minor = 1, major = 5, critical = 25.
Dos decisiones de diseño mejoran la fiabilidad práctica.
En primer lugar, el razonamiento está habilitado para los evaluadores. Sin esta configuración, los LLM pueden atribuir errores que no están presentes y producir puntuaciones sin una base clara en la traducción. Con el razonamiento habilitado (thinking_budget=-1 dinámico para Gemini y reasoning_effort=medium para GPT), las anotaciones resultan coherentes y auditables.
En segundo lugar, la instrucción indica expresamente que las variantes regionales y dialectales son traducciones válidas. Así se compensa el sesgo de MetricX hacia el idioma estándar. Una salida correcta en árabe egipcio no debe penalizarse por usar esa variedad y el diseño de la instrucción de GEMBA lo contempla.
Actualmente ejecutamos varios evaluadores a la vez. Cada uno escribe en su propio directorio de resultados; el informe detecta automáticamente todos los evaluadores y muestra una columna por cada uno. Una coincidencia amplia aporta una señal con mayor confianza. Las divergencias señalan dónde la propia métrica mantiene incertidumbre, lo que también resulta útil.
¿Qué es GEMBA Rate? GEMBA Rate, mostrado como GEMBA Combined en la herramienta, es la puntuación media de todos los evaluadores activos para una celda concreta de sistema y combinación lingüística. Es la cifra resumida de GEMBA. Las columnas individuales, por ejemplo GEMBA Gemini-3.1-Flash-Lite y GEMBA GPT-5.4-Mini, aparecen al lado para mostrar dónde coinciden o divergen los evaluadores. Si la tasa combinada es baja y las puntuaciones individuales son próximas, la señal de calidad tiene más confianza. Si divergen de forma notable, la tasa combinada debe interpretarse como orientativa y conviene revisar las columnas individuales.
Cómo interpretar ambas métricas
MetricX indica cuánto se aproxima la salida a una referencia estándar. GEMBA indica si un lector cualificado encontraría errores en ella.
Cuando ambas métricas ofrecen un resultado sólido, la señal es consistente. Si MetricX puntúa un sistema peor que GEMBA, puede tratarse de una salida regional auténtica penalizada por MetricX. Si GEMBA puntúa peor que MetricX, la salida puede estar cerca de la referencia y contener, aun así, problemas reales de fluidez o exactitud.
Ambas puntuaciones usan la misma escala de 0–25 y, en las dos, un valor menor es mejor.
Intervalos de confianza
Cada celda del informe muestra mean ± half-width de un intervalo de confianza bootstrap del 95% sobre la media de los segmentos.
Este dato recibe menos atención de la necesaria en muchos informes. Con 960 segmentos, los intervalos del sistema suelen ser estrechos, en torno a ±0.02. Por combinación lingüística son más amplios, alrededor de ±0.10, pero siguen aportando información.
La consecuencia práctica es que dos sistemas cuyos intervalos se solapan están empatados estadísticamente. No resulta defendible situar uno por encima del otro. El informe refleja esta limitación y no declara un ganador cuando los datos no lo respaldan.
Coste: cuánto cuesta ejecutar el sistema al ritmo del habla
La cifra $/hr del informe no es una tabla de precios de API. Es una estimación del coste de ejecutar cada sistema como una única emisión de traducción en tiempo real para un hablante.
Usamos aproximadamente 750 caracteres por minuto como referencia, a partir de una cadencia media en inglés. La emisión de producción más rápida que hemos observado alcanza unos 1,200 cpm; los costes aumentan linealmente.
Para los sistemas LLM, el coste se calcula por token a partir de la instrucción de producción y una ventana de contexto acumulada de 7 fragmentos, sin aplicar un descuento por caché de instrucciones, lo que ofrece una estimación conservadora. Para los sistemas NMT, como DeepL, Google Translate y Amazon Translate, se calcula por carácter según tarifas públicas o contratadas.
Una precisión importante: los sistemas en modo párrafo muestran la estimación del modo oración, porque la producción nunca se ejecuta en modo párrafo. Estimar el modo párrafo reduciría artificialmente el coste y llevaría a decisiones de despliegue incorrectas.
Clasificación de fallos
Esta es una parte que muchos benchmarks omiten.
Una traducción deficiente obtiene una puntuación alta. Un fallo catastrófico, por ejemplo un sistema que rechaza traducir, entra en un bucle o devuelve una cadena vacía, podría registrarse como cero, distorsionar la media y ocultar el riesgo real.
Etiquetamos cada segmento con uno o más indicadores de fallo. Un segmento se considera fallido si se activa cualquiera de ellos. Las traducciones deficientes que sí son salidas válidas no se marcan: aparecen con puntuaciones altas en MetricX y GEMBA.
Fallos de API son los más relevantes desde el punto de vista operativo:
stuck: bucle de descodificación degenerado. El modelo emite repetidamente el mismo token, normalmente tras recibir texto de origen con caracteres repetidos (noooooOOOOoo,waaaaahoooo!!). Aumentar el presupuesto de tokens produce más tokens repetidos, no una traducción mejor, por lo que limitamos la salida y la marcamos.refused: el modelo rechazó traducir. Incluye el filtro contra memorización de Gemini (RECITATION), los filtros de seguridad y las listas de bloqueo de contenido. El segmento queda inaccesible para ese sistema.api_error: fallos de infraestructura, como errores 4xx distintos de 429 y tiempos de espera de gRPC agotados tras los reintentos. Es la categoría que conviene revisar cuando se pregunta si la integración ha fallado.empty: la llamada a la API fue correcta, pero el modelo devolvió una cadena vacía. Se distingue de los fallos anteriores.
Fallos de estructura de salida detectan modelos que técnicamente devolvieron contenido, pero no una traducción:
untranslated: la hipótesis coincide con el origen. Omitimos segmentos breves, texto principalmente no alfabético y contenido que no debe traducirse, como hashtags, URL o menciones.markdown_fence: el modelo envolvió la salida en bloques de código pese a la instrucción expresa de no hacerlo.preamble: la salida comienza con"Translation:","Here's the translation"o equivalentes regionales. El modelo no siguió el formato de salida.reasoning_leak: el modelo expuso su razonamiento interno en la salida. Esto indica una configuración incorrecta de un modelo de razonamiento híbrido.multiple_alternatives: el modelo ofreció varias opciones en vez de una sola traducción.translator_note: el modelo añadió una nota final entre paréntesis.
La columna de tasa de fallos agrega todos estos indicadores. Un sistema con una tasa de fallos del 0% para una combinación lingüística concreta difiere de otro con un 2–3%, especialmente en una emisión en directo, donde un segmento fallido genera silencio o contenido incorrecto.
Qué implica para las decisiones de producción
Creamos este marco y lo ofrecemos públicamente porque la selección de un motor de traducción no es una decisión que se tome una sola vez.
Cambian las capacidades de los modelos, aparecen versiones, se modifican los precios y aumenta la cobertura de combinaciones lingüísticas. El sistema adecuado para inglés → español hace seis meses puede no serlo hoy.
Ejecutamos la evaluación de forma continua. La herramienta refleja el rendimiento actual, no benchmarks archivados.
Para cadenas y servicios de streaming que operan en mercados multilingües, elegir un motor inadecuado para una combinación lingüística puede reducir la calidad, aumentar el coste o elevar el riesgo de fallo en contenido en directo. La decisión requiere datos, no suposiciones.
El marco está diseñado para aportar esos datos.
La herramienta de comparación de motores de traducción automática es gratuita. Solicite acceso en syncwords.com o contacte directamente con nosotros para revisar los datos de sus combinaciones lingüísticas.
Compare motores de traducción con nuestra herramienta gratuita
Solicitar acceso gratuito